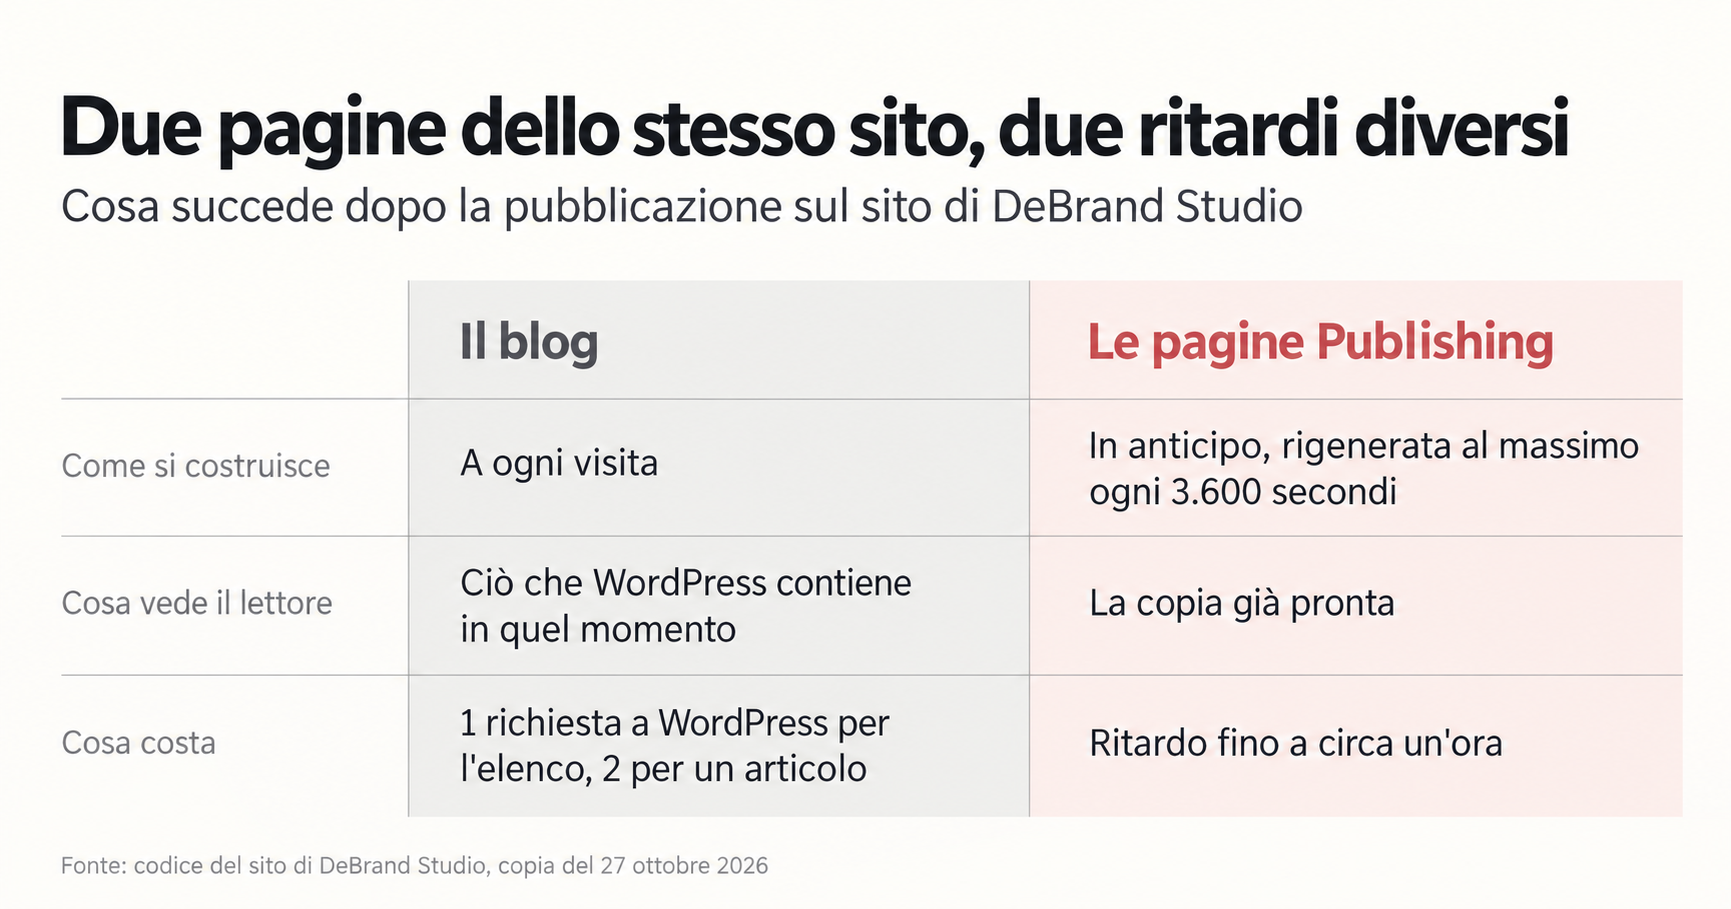
Sul sito di DeBrand Studio due pagine si aggiornano in modo opposto. Il blog viene costruito a ogni visita: chi lo apre vede ciò che WordPress contiene in quel momento. Due pagine Publishing, dove escono a data fissa le puntate di una serie, vengono preparate in anticipo e rigenerate al massimo una volta ogni 3.600 secondi, cioè un’ora.
Chi pubblica sul sito di un’azienda prima o poi si fa la stessa domanda: ho premuto «Pubblica» e la pagina non c’è, si è rotto qualcosa? In un sito WordPress headless la risposta parte da un’altra domanda: come è costruita quella pagina? Headless significa che WordPress resta il posto dove si scrive. Il sito che i lettori visitano, il frontend, è un’altra applicazione (qui Next.js, versione 16.1.1) che chiede a WordPress i contenuti. Da quando i due sono separati, il tempo tra «Pubblica» e la pagina visibile si decide pagina per pagina.
Un’avvertenza: DeBrand Studio realizza siti con questa architettura e debrandstudio.it è costruito così. Ho interesse a farla sembrare ragionevole, e per questo il pezzo dice anche quando non lo è. Quello che segue sul sito dello studio viene dal suo codice, in una copia del 27 ottobre 2026: descrive ciò che il codice dichiara.
Due modi di costruire una pagina
Next.js può costruire una pagina in due momenti. Nel primo la costruisce a ogni visita: riceve la richiesta, chiede i dati a WordPress, compone la pagina e la manda al lettore. È una pagina dinamica. Il contenuto è sempre quello attuale, ma ogni visita costa una richiesta a WordPress.
Nel secondo momento la pagina è costruita in anticipo e conservata dal sito in una memoria temporanea, la cache. I lettori ricevono quella copia senza disturbare WordPress. Questo modo si chiama ISR, da Incremental Static Regeneration, in italiano rigenerazione statica incrementale. La copia viene rigenerata in due casi. Il primo è la scadenza di un tempo stabilito (revalidation a tempo). Il secondo è un avviso di WordPress al sito, che segnala un cambiamento (revalidation su richiesta), di solito tramite un webhook, cioè una chiamata automatica a un indirizzo del sito.
Un paragone da cucina aiuta a vedere la differenza. La pagina dinamica è il piatto cucinato all’ordine: sempre fresco, con la cucina al lavoro per ogni cliente. L’ISR è il banco dei piatti pronti: serviti subito, ma preparati prima. Il paragone regge sui tempi e si ferma alla sostituzione. In cucina il piatto scaduto si butta. Con l’ISR, secondo la documentazione di Next.js sulla revalidation, la copia vecchia continua a essere servita finché quella nuova non è pronta (lo schema si chiama stale-while-revalidate). Il primo visitatore dopo la scadenza può quindi vedere ancora la pagina vecchia.
Altre guide descrivono un secondo modello. Next.js 16 documenta anche un nuovo modo di dichiarare che cosa tenere in cache, chiamato Cache Components. L’annuncio della versione, il 21 ottobre 2025, lo descrive come interamente opt-in, cioè da attivare. Il file next.config.ts del sito non lo attiva, quindi qui vale il modello precedente, quello di force-dynamic e revalidate che compaiono nelle prossime sezioni.
Il blog sempre aggiornato costa una richiesta a visita
Nel codice del sito le pagine /blog e /blog/[slug], e anche la sitemap, portano la riga export const dynamic = "force-dynamic", che le obbliga a essere costruite a ogni richiesta. Il commento accanto, scritto in inglese, dice perché: evitare di conservare risposte vuote durante la costruzione del sito prima della messa online (la build), quando WordPress non è raggiungibile. Se il sito viene costruito mentre WordPress non risponde, una pagina statica nascerebbe senza articoli.
Il prezzo di questa scelta sono le richieste. Per l’elenco del blog il codice invia a WordPress una richiesta a ogni visita. La richiesta usa GraphQL, il linguaggio con cui il sito interroga l’API di WordPress, cioè la porta d’accesso ai suoi dati. Per un articolo ne invia due: una per i metadati della pagina (titolo e descrizione per i motori di ricerca) e una per il testo. Il conteggio viene dalla lettura del codice, non da una misura, e il codice non dice se Next.js ne unisca qualcuna.
Per questo nel blog dello studio non vale il principio «meno chiamate API per pagina». La documentazione di fetch in Next.js 15 dice che in una pagina statica la richiesta parte una volta sola, durante la build, e in una dinamica a ogni richiesta. Le chiamate in meno valgono quindi solo per le pagine statiche o in ISR. Qui accade il contrario: più visite significano più richieste a WordPress.
La scelta ha anche un comportamento quando WordPress si ferma. L’elenco mostra «Nessun articolo trovato» e la pagina di un articolo mostra la pagina «non trovato» (nel codice, notFound()). Per il lettore un guasto di WordPress somiglia a un blog senza articoli.
Per chi scrive il risultato è semplice. Quando pubblico un articolo sul blog, compare «dopo qualche istante»: è un’osservazione a occhio, non una misura. Nel codice non c’è nulla che avvisi Next.js quando WordPress pubblica, né webhook né revalidation su richiesta. Non serve, perché il blog non ha una copia da rinfrescare.
Le pagine Publishing sono pronte in anticipo
Le pagine Publishing fanno la scelta contraria. Due pagine della sezione dichiarano revalidate = 3600. Il commento nel codice dice che l’ultimo appuntamento cambia da solo quando le uscite programmate vanno online. Ogni puntata ha una data di uscita (publishAt) e compare solo quando quella data è passata. La prima puntata di una serie, per esempio, era fissata per il 19 settembre 2026 a mezzanotte.
I testi di queste puntate non stanno in WordPress ma in file della cartella content/ del sito, quindi qui WordPress non c’entra. Il caso serve lo stesso, perché mostra l’ISR su un contenuto che cambia con l’orologio e non con un clic. Per queste pagine l’ISR a tempo è la scelta naturale. Nessuno preme «Pubblica» all’ora dell’uscita, quindi non esiste un evento da comunicare al sito: l’unico segnale è la data, che il sito controlla ogni volta che rigenera la pagina.
Il prezzo è il ritardo. La copia resta valida 3.600 secondi; dopo, la prima visita riceve ancora quella vecchia e fa partire la rigenerazione, e la visita successiva trova la pagina nuova. Una puntata fissata a mezzanotte può quindi comparire con un ritardo fino a circa un’ora, e con più ritardo se nessuno visita la pagina nel frattempo.
L’alternativa è la revalidation su richiesta: alla pubblicazione WordPress chiama un indirizzo del sito, che invalida la pagina o un’etichetta (tag) associata ai suoi dati. Nel sito dello studio non c’è: non risulta né nel codice del frontend né in quello di WordPress. Parte alla pubblicazione invece che alla scadenza, ma non è istantanea. Per revalidateTag la documentazione di Next.js dice che la richiesta successiva avvia la rigenerazione e riceve il contenuto vecchio finché questa non finisce. Anche con l’avviso, quindi, il primo visitatore può vedere ancora la pagina vecchia.
Dove si nasconde il ritardo
In un’architettura headless le cache sono almeno due. C’è quella di Next.js, e c’è quella che WordPress può avere per conto suo: la cache di pagina di un plugin o una cache di oggetti. Quando Next.js rigenera una pagina, chiede i contenuti a WordPress. Se WordPress risponde con una copia vecchia, la pagina nuova nasce vecchia. È un ragionamento e non una citazione: la documentazione di Next.js descrive la propria cache e non risulta una fonte ufficiale che tratti questo caso. Chi gestisce un sito così deve però sapere quali cache ci sono da entrambi i lati, prima di cercare il guasto.
Il secondo punto riguarda dove gira il sito. Quello dello studio gira in un container Docker (un pacchetto che racchiude il programma e ciò che gli serve), non su Vercel, la piattaforma dei creatori di Next.js. In questo caso la cache dell’ISR è locale all’istanza, cioè alla singola copia del sito in esecuzione. La documentazione sui cache handler spiega che per conservarla in uno spazio durevole o condividerla tra più container serve configurare un cacheHandler. Quella sull’ISR precisa che la rigenerazione avviene sull’istanza che riceve la richiesta. Con più istanze, due visitatori possono quindi ricevere versioni diverse della stessa pagina, finché ciascuna non ha rigenerato la propria copia. Il codice non dice quante istanze girino in produzione.
I metadati SEO arrivano da Yoast
Chi scrive su WordPress compila in Yoast, il plugin SEO, il titolo e la descrizione che compariranno nei risultati di ricerca e nelle anteprime sui social. Il sito li legge da WordPress nel campo seo della richiesta GraphQL: titolo, descrizione, titolo e descrizione per Open Graph (le anteprime sui social), immagine. Poi li passa a generateMetadata, la funzione di Next.js che costruisce i tag nella testata della pagina. Se i campi di Yoast sono vuoti, il codice ripiega sul titolo e sull’estratto dell’articolo.
Un dettaglio vale per chi controlla l’indirizzo canonico, quello che dice a Google qual è la versione ufficiale di una pagina. Nel blog dello studio non viene da Yoast: la richiesta non lo chiede, e il codice lo costruisce unendo l’indirizzo del sito e lo slug, la parte finale dell’indirizzo dell’articolo. Sul blog, chi cambia l’indirizzo canonico in Yoast non cambia nulla.
Per il tempo, i metadati seguono la pagina. Se si cambia un titolo SEO, il blog lo legge alla visita successiva; in una pagina in ISR la modifica aspetterebbe la rigenerazione, come ogni altro contenuto. La sitemap segue lo stesso principio. È l’elenco delle pagine che Google legge per scoprirle, ed è costruita a ogni richiesta, con gli articoli letti da WordPress e le puntate già uscite. Un articolo pubblicato compare nell’elenco alla richiesta successiva.
Esiste anche la via REST. La documentazione per sviluppatori di Yoast descrive i campi yoast_head e yoast_head_json nelle risposte dell’API REST di WordPress. Per GraphQL, un articolo di WPGraphQL del 24 settembre 2026 mostra l’impostazione con Yoast e Next.js App Router, dichiarandola aggiornata a Next.js 16.
Quando ha senso, e quando no
Ogni scelta qui sopra ha un controargomento. Il blog dinamico è più semplice e sempre aggiornato, ma pesa su WordPress a ogni visita. L’ISR alleggerisce WordPress e ritarda l’aggiornamento. L’avviso da WordPress accorcia il ritardo e aggiunge un pezzo da mantenere. Nessuna delle tre è migliore in assoluto: dipende da quanto ritardo il contenuto tollera e da quanto traffico deve reggere WordPress.
L’headless ha anche costi propri. Pantheon, un fornitore di hosting con interesse commerciale sull’argomento, in una pagina aggiornata al 25 agosto 2026 scrive che non tutti i plugin espongono i propri dati tramite API. Aggiunge che l’anteprima per i redattori, immediata in un sito WordPress tradizionale, va spesso ricostruita con chiamate API, token di accesso e logica nel frontend. Elenca infine il lavoro continuo su aggiornamenti di API e dipendenze, cache, errori di build, monitoraggio e sicurezza. La stessa pagina chiede di definire prima dello sviluppo modelli di contenuto, regole di cache e chi possiede cosa tra WordPress e frontend.
A mio giudizio un sito che cambia raramente e ha poche pagine, curato da chi già conosce WordPress, di solito non ci guadagna. Due sistemi da mantenere costano più di quanto restituiscono. Vendo questo lavoro, e il giudizio va letto sapendolo. Il discorso cambia, sempre a mio giudizio, quando WordPress da solo non regge il traffico di lettura o quando gli stessi contenuti devono arrivare a più siti e applicazioni. Anche allora l’headless si paga con lavoro che va messo nel preventivo.
Prima di scegliere, quindi, la domanda da farsi è una per ogni tipo di contenuto: quanto ritardo si accetta tra «Pubblica» e la pagina visibile? Per un avviso di chiusura, nessuno. Per la pagina «Chi siamo», molto. Dalla risposta dipende se quel contenuto va costruito a ogni visita, rigenerato a tempo o aggiornato su avviso.
Se vuoi fare questo conto sulle pagine del tuo sito, DeBrand Studio offre un audit per le PMI.
Cesare Max Brandini è consulente cloud e IA e CEO di DeBrand Studio, dove progetta sistemi web, cloud e di intelligenza artificiale per le PMI. Scrive narrativa e articoli.